Классификация в машинном обучении
Богдан Немешаев · Опубликовано:
Письмо — спам или полезное сообщение? К какой теме относится обращение и какой товар изображён на фотографии? Классификация помогает модели выбирать категории по признакам объекта. Для обучения ей показывают примеры с известными метками, а качество проверяют на новых случаях.
Разберём, как поставить такую задачу, чем различаются её виды и какие методы используют. На учебном спам-фильтре посмотрим, почему большая доля правильных ответов ещё не означает, что систему можно применять без проверки ошибок.
Что такое классификация в машинном обучении
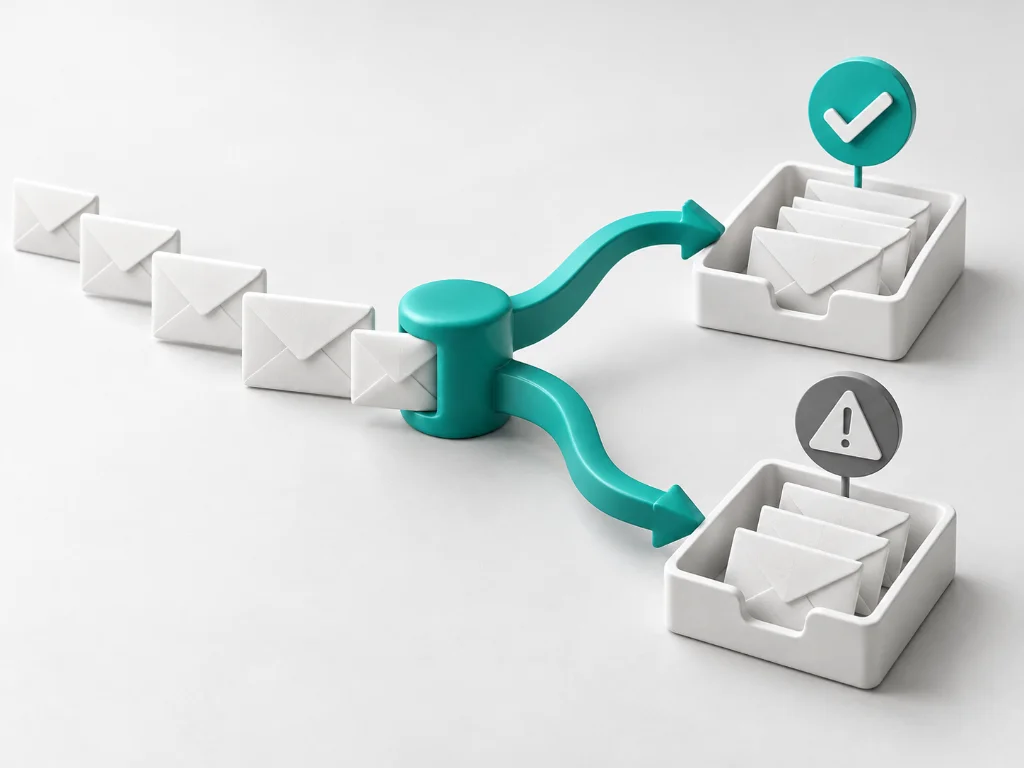
Классификация — задача определения заранее заданной категории по характеристикам объекта. Объект — отдельное письмо, обращение или изображение. Его характеристики называют признаками, возможную категорию — классом, а отметку о принадлежности конкретного примера к классу — меткой.
В спам-фильтре объектом служит письмо, признаками могут быть слова и характеристики ссылок, а классами — «спам» и «полезное письмо». У проверенного человеком сообщения уже есть метка. На таких примерах обучают классификатор — модель, которая затем предсказывает класс нового письма.
Это одна из задач обучения с учителем: известные метки помогают найти связь между признаками и ответами. Саму задачу нужно отличать от алгоритма её решения. Классификацию объектов выполняют разные модели; перечень видов нейросетей относится к другой теме и не объясняет, как определяют класс письма или фотографии.
Где применяется классификация
Ниже приведены учебные сценарии. Они показывают постановку задачи, а не результаты конкретных внедрений.
Спам-фильтр. Для обучения берут прошлые письма с проверенными метками. Текст и другие доступные сведения преобразуют в признаки. Например, у нежелательной рассылки известна метка «спам». Когда приходит новое письмо, модель оценивает его по тем же видам признаков и предлагает класс. Результат можно использовать для перемещения письма в отдельную папку; правило действия выбирают с учётом риска потерять полезное сообщение.
Распределение обращений. Вход — текст сообщения, известная метка — тема, назначенная по правилам поддержки. Для нового обращения «Хочу вернуть заказ, деньги ещё не поступили» нужно заранее решить, выбирать ли одну основную тему или сразу две метки: «возврат» и «оплата». В первом случае результат может определять очередь, во втором — набор задач для сотрудников. Если сообщение неоднозначно, его передают человеку, а не считают любой ответ модели окончательным.
Категории изображений. В учебном каталоге фотографии заранее отмечены как «обувь», «сумка» или «головной убор». Модель получает числовое представление изображения, учится по известным меткам и для новой фотографии предлагает раздел каталога. Если на снимке несколько товаров или предмет из неизвестной категории, первоначальная постановка с одним классом может оказаться неподходящей.
Во всех трёх случаях модель работает с представлением входных данных, подготовленным для выбранного метода. Результат — предсказание, которое может ошибаться. Что делать с этим результатом, определяет приложение: показать подсказку, направить объект в очередь или запросить проверку.
Бинарная, многоклассовая и многометочная классификация
Вид классификации зависит от числа возможных классов и от того, сколько меток разрешено назначить одному объекту.
- Бинарная классификация: два класса, для каждого объекта выбирают один. В нашем примере это «спам» или «полезное письмо».
- Многоклассовая классификация: классов больше двух, но ответ по-прежнему один. Обращение относят к основной теме «оплата», «доставка» или «возврат», если правила требуют выбрать только её.
- Многометочная классификация: одному объекту можно назначить несколько меток одновременно. Обращение может касаться и оплаты, и возврата. Если постановка это допускает, объект может не получить ни одной метки из заданного набора.
Список классов задают при подготовке задачи. Модель, обученная различать три вида товаров, не получает автоматически способность распознавать четвёртый. Категория «другое» тоже требует понятного определения и подходящих примеров; одно её название не обеспечивает распознавание всех неизвестных объектов.
Какие методы используют
Алгоритмы классификации различаются способом работы с признаками и построения решения. Ниже — обзор, который помогает понять их роль без формул.
- Логистическая регрессия оценивает вероятности категорий по сочетанию признаков. Несмотря на название, это метод классификации. Вероятностная оценка модели не является гарантией правильности ответа.
- Дерево решений последовательно проверяет условия по признакам. Объект проходит по ветвям к группе обучающих примеров, на основе которой определяется предсказание.
- Случайный лес объединяет множество деревьев, обученных с элементами случайного выбора данных и признаков. Их ответы объединяют, чтобы получить итоговую оценку класса.
- Бустинг строит ансамбль — сочетание нескольких моделей — последовательно. Новые модели помогают исправлять ошибки уже построенной совокупности. Часто в качестве отдельных моделей используют деревья.
- Метод ближайших соседей определяет класс по похожим размеченным объектам. Результат зависит от того, какие признаки выбраны и как измеряется близость; несопоставимые масштабы числовых признаков могут исказить сравнение.
- Метод опорных векторов, или SVM, строит разделяющую границу между классами с учётом ближайших к ней обучающих примеров. В зависимости от настройки граница может быть линейной или более сложной.
- Нейросети обучают преобразования входных данных и выход для выбора классов. Их используют, в частности, для текстов и изображений. Способность описывать сложные зависимости не отменяет требований к меткам и проверке ошибок.
Выбор метода зависит от данных, последствий ошибок, скорости работы и требований к объяснению результата. Несколько вариантов сравнивают на одинаковой задаче и проверочных примерах. Название алгоритма само по себе не говорит, какой вариант окажется лучше.
Какие данные нужны модели
Разметка связывает примеры с правильными по условиям задачи метками. Для писем нужно определить, какие рассылки считать нежелательными. Для обращений — как различать близкие темы и отмечать несколько вопросов. Если два сотрудника понимают классы по-разному, модель получает противоречивые ответы. Часть разметки полезно проверить независимо и разобрать расхождения.
Признаки должны быть доступны при обработке нового объекта. Например, нельзя использовать название очереди, которую сотрудник назначит обращению позже. Такая подсказка создаёт утечку данных: при проверке модель выглядит успешнее, чем при реальном применении.
Обучающая выборка нужна для обучения, валидационная — для выбора модели, настроек и правил решения. Тестовую выборку оставляют для итоговой независимой проверки. Подготовку признаков, зависящую от данных, настраивают только по обучающей части. Копии одного письма и сообщения одной переписки не стоит разносить между обучением и тестом, если нужно проверить работу на новых переписках.
Дисбаланс классов означает, что примеров одних категорий заметно больше, чем других. Редкая тема может почти не влиять на общую долю правильных ответов, хотя её пропуск важен. Нужно проверять представленность классов и ошибки по каждому из них. Если редких примеров мало, оценка их качества остаётся ненадёжной; изменение весов классов при обучении не создаёт недостающих наблюдений.
Проверочные данные должны отражать будущую работу. Для потока новых писем полезна проверка на более позднем периоде. Смена языка, источников сообщений или ассортимента может потребовать новых примеров и повторной оценки модели.
Как оценивать ошибки классификации
У спам-фильтра два разных промаха. Пропущенный спам попадает во входящие и требует внимания пользователя. Ошибочно заблокированное полезное письмо может оставить без ответа важное сообщение. Если считать «спам» положительным классом, первый случай называют ложноотрицательным, второй — ложноположительным ответом.
Представим учебную проверку на 1 000 письмах: 50 из них — спам, 950 — полезные. Если разрешить все письма, общая доля правильных ответов, или accuracy, составит 95%. При этом фильтр не поймает ни одного спам-письма. Поэтому высокая общая точность классификации сама по себе недостаточна.
Матрица ошибок сопоставляет фактические классы с предсказанными и показывает, какие объекты перепутаны. Допустим, другая модель дала следующие условные результаты на тех же 1 000 письмах. Строки показывают фактическую метку, столбцы — решение модели.
| Фактический класс | Модель: спам | Модель: полезное письмо |
|---|---|---|
| Спам | 40 поймано | 10 пропущено |
| Полезное письмо | 20 заблокировано по ошибке | 930 пропущено верно |
Теперь правильных ответов 970, то есть 97%, но за этой долей скрываются 20 ошибочно заблокированных полезных писем. Оценивать модель нужно с учётом того, приемлемы ли такие последствия для выбранного применения.
Precision отвечает на вопрос: какая часть писем, отмеченных как спам, действительно была спамом? В примере это 40 из 60. Recall, или полнота, показывает, какую часть всего настоящего спама удалось поймать: 40 из 50. Первая метрика помогает оценить надёжность блокировки, вторая — количество найденного спама относительно всего спама.
Порог классификации задаёт границу, при достижении которой оценку модели считают достаточной для выбора класса. Например, если модель оценивает вероятность спама, более высокий порог требует большей уверенности для блокировки. Это может уменьшить число ошибочно заблокированных полезных писем, но увеличить число пропусков спама. Снижение порога действует в обратную сторону. Порог выбирают на валидационных данных по последствиям ошибок, а затем проверяют на тестовых. Подбирать его по итоговому тесту нельзя.
F1-мера объединяет precision и recall в один показатель, но не учитывает автоматически стоимость разных ошибок. Поэтому вместе с метриками рассматривают сами перепутанные письма. Для нескольких классов проверяют ошибки по каждому классу, для нескольких меток — ещё и полноту нужного набора меток.
Отличия от регрессии и кластеризации
Регрессия в машинном обучении прогнозирует числовую величину: например, сумму покупки. Классификация определяет категорию: например, тему обращения. Если «оплата», «доставка» и «возврат» закодированы числами 1, 2 и 3, эти числа остаются названиями классов. Усреднение таких кодов не делает результат содержательным числовым прогнозом.
Кластеризация ищет группы похожих объектов без заранее заданных целевых меток для обучения. Можно сгруппировать обращения по сходству текстов и затем изучить темы внутри групп. Но найденный кластер не становится автоматически готовой категорией поддержки: он может объединить несколько тем или разделить одну тему по стилю сообщений.
Практический выбор зависит от вопроса. Если категории уже определены и есть размеченные примеры, можно проверять классификатор. Если сначала нужно разобраться в структуре неизвестного набора данных, группировка объектов решает другую задачу.
Когда классификация полезна и где нужен человек
Классификация полезна для повторяющихся задач с понятными категориями и проверяемыми ответами. Она может помогать сортировать объекты и предлагать решения сотруднику. Польза зависит не только от метрик, но и от того, как приложение обрабатывает ошибки.
- Неоднозначные объекты. Одно обращение может затрагивать несколько тем, а фотография — не давать достаточно информации. Нужно предусмотреть несколько меток, уточнение или ручную проверку.
- Неизвестные категории. Новый тип товара или письма может быть уверенно отнесён к знакомому классу по ошибке. Высокая оценка модели не доказывает, что объект относится к изученному набору категорий.
- Ошибки разметки и переобучение. Модель может воспроизводить неверные метки или запоминать частные особенности обучающих примеров. Независимая проверка помогает выявить проблему, но не заменяет исправление данных.
- Изменение потока. Новые формулировки спама, правила поддержки или условия съёмки меняют входные данные. После запуска продолжают собирать проверенные ответы и оценивать ошибки.
- Последствия решения. Подсказка оператору и автоматическая блокировка требуют разных правил. Для спорных или важных случаев предусматривают возможность проверки и исправления человеком.
Перед применением определяют, какие решения можно принимать автоматически, какие объекты нужно передавать сотруднику и как замечать ухудшение качества. Классификатор тогда становится частью понятного процесса, а не источником безусловно правильных меток.