Регрессия в машинном обучении
Богдан Немешаев · Опубликовано:
Сколько может стоить квартира и сколько товаров удастся продать на следующей неделе? Когда от модели нужен числовой прогноз, решают задачу регрессии. Для этого ищут закономерности в прошлых наблюдениях и проверяют, помогают ли они оценивать новые случаи.
Разберём регрессию на учебном примере цены квартиры: от выбора данных до оценки ошибки. Затем посмотрим, как тот же подход применяют к продажам и почему даже хороший прогноз требует проверки условий.
Что такое регрессия в машинном обучении
Регрессия — задача предсказания числового значения по характеристикам объекта. Характеристики называют признаками, а величину, которую нужно предсказать, — целевым значением. Для квартиры признаками могут быть площадь, район и состояние, а целевым значением — цена сделки в рублях.
При обучении с учителем модель получает примеры с уже известными ответами. Регрессионная модель — полученное по этим примерам правило числового прогноза. Оно должно работать и для объектов, которых не было при обучении.
Регрессия не сводится к одному алгоритму. Линейная регрессия, дерево и нейросеть могут решать одну задачу разными способами. В регрессионном анализе также изучают связи между величинами; в прикладной задаче машинного обучения особенно важно проверить качество прогноза на новых наблюдениях.
Какие задачи решает регрессия
Оценка цены квартиры. В учебном сценарии нужно оценить возможную цену продажи по данным, доступным до сделки: площади, местоположению, этажу, состоянию жилья. Для обучения собирают прошлые объекты с такими характеристиками и фактическими ценами. Для новой квартиры модель выдаёт число, которое можно использовать как ориентир при сравнении объектов. Это не гарантированная цена будущей сделки.
Сначала нужно договориться, что именно прогнозировать. Цена в объявлении и сумма завершённой сделки — разные целевые значения. Если обучаться на объявлениях, нельзя без отдельной проверки называть результат прогнозом фактической цены продажи.
Прогноз продаж. Другой учебный пример — число проданных единиц товара за следующую неделю. Входными данными могут быть продажи прошлых недель, календарь, заранее известная цена и запланированная акция. Ответом при обучении служит фактическое число продаж за соответствующую неделю. Прогноз помогает подготовить план закупок, а его пользу проверяют по последующим результатам.
Для прогноза спроса нужно учитывать ещё и доступность товара. Если товар закончился, низкие продажи не обязательно означают низкий спрос. Сезонность и изменение цен также требуют внимания: история одного спокойного месяца не показывает, как модель поведёт себя в праздничный период.
Как модель получает прогноз
Представим несколько записей о квартирах. Все числа в таблице условные: это учебная иллюстрация устройства данных, а не сведения о реальном рынке.
| Площадь | Район | Состояние | Цена сделки |
|---|---|---|---|
| 38 м² | Северный | Без ремонта | 4,2 млн руб. |
| 54 м² | Северный | С ремонтом | 6,3 млн руб. |
| 70 м² | Центральный | С ремонтом | 9,1 млн руб. |
Каждая строка описывает один объект. Площадь, район и состояние подают на вход, цену используют как известный ответ. Категории вроде района заранее переводят в представление, подходящее выбранной модели. Три строки помогают понять принцип, но не подтверждают достаточность данных для реального прогноза.
Во время обучения алгоритм подбирает правило, связывающее признаки с ценой, с учётом ошибок на обучающих примерах. У линейной модели это подбор вкладов признаков, у дерева — условий разделения объектов на группы. Способ обучения зависит от выбранного метода.
После проверки модели ей передают новую квартиру: например, 50 м², Северный район, с ремонтом. Цена сделки ещё неизвестна и на вход не поступает. Допустим, модель выдала 6 млн рублей — это тоже условный прогноз. Когда появится фактическая цена, с ней можно будет сравнить оценку.
Какие методы регрессии бывают
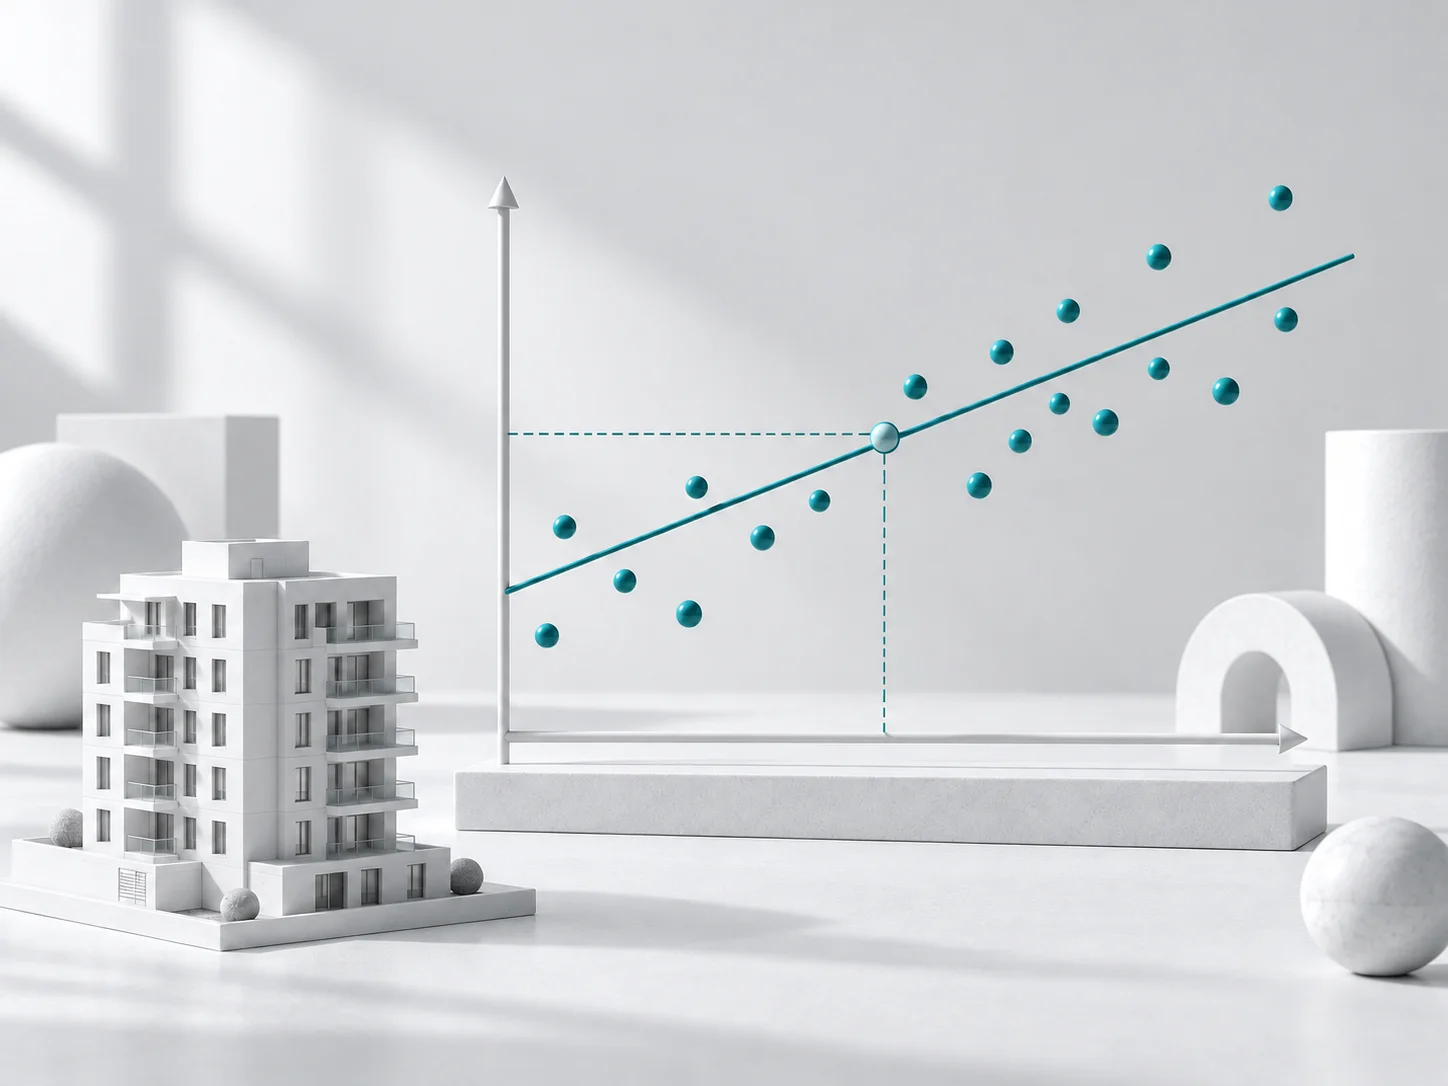
Линейная регрессия складывает вклады признаков с весами, подобранными при обучении, и постоянную составляющую. В простом примере она связывает цену только с площадью. Такой исходный вариант удобно проверять и сравнивать с более сложными моделями, но он может упускать важные особенности жилья.
Множественная линейная регрессия использует несколько признаков: например, площадь, возраст дома и расстояние до центра. Добавление признаков само по себе не делает модель нелинейной. Число признаков и форма зависимости — разные свойства модели.
Нелинейные зависимости возникают, когда связь нельзя достаточно хорошо описать постоянными вкладами исходных признаков. Например, в учебной задаче дополнительная площадь может по-разному менять прогноз для маленьких и больших квартир. Такие связи можно описывать преобразованиями признаков или другими моделями; выбор проверяют на данных.
Дерево решений последовательно проверяет условия по признакам и выдаёт числовую оценку для получившейся группы. Ансамбль объединяет несколько моделей. Случайный лес усредняет прогнозы множества деревьев, а градиентный бустинг последовательно добавляет модели, которые помогают уменьшать ошибку общего прогноза.
Нейросеть с выходом для числового прогноза тоже решает задачи регрессии и может описывать сложные связи. Однако сложность не гарантирует меньшую ошибку. Методы сравнивают на одинаковых проверочных примерах, учитывая качество, понятность результата, время расчёта и затраты на поддержку.
Какие данные нужны
Нужны прошлые наблюдения с надёжными числовыми ответами. Для квартир проверяют единицы площади, валюту, пропуски, повторные записи об одном объекте и единое определение цены. Необычное значение сначала разбирают: это может быть как ошибка ввода, так и реальная дорогая квартира.
Выбор признаков для регрессии ограничен моментом прогноза. Нельзя использовать итоговый торг или сведения, появившиеся после сделки, если оценку нужно получить раньше. Иначе возникает утечка ответа: модель получает подсказку, которой не будет при настоящем применении.
Данные разделяют по назначению. На обучающей части подбирают модель, на валидационной — сравнивают варианты и настройки. Тестовую часть оставляют для независимой итоговой проверки. Правила заполнения пропусков и другие преобразования, зависящие от данных, также подбирают по обучающей части. Повторные записи одного объекта не должны создавать видимость проверки на новых квартирах.
Во временных задачах сохраняют порядок событий: обучаются на более раннем периоде и проверяют на более позднем. Для продаж случайное перемешивание недель может позволить модели использовать сведения из будущего. Полезно повторить проверку на нескольких последовательных периодах, включая сезоны, для которых нужен прогноз.
Как оценить ошибку прогноза
Для каждого проверочного объекта сопоставляют прогноз и фактическое значение. Если в учебном примере прогноз равен 6 млн рублей, а сделка состоялась за 6,3 млн, модель недооценила квартиру на 300 тысяч рублей. Важно видеть и размер ошибки, и её направление.
Средняя абсолютная ошибка, или MAE, показывает средний размер расхождения без учёта знака: завышение и занижение не погашают друг друга. Если на трёх условных проверочных объектах размеры ошибок составили 300, 600 и 300 тысяч рублей, MAE равна 400 тысячам рублей. Она выражена в тех же единицах, что и цена; меньшая MAE на одних и тех же данных означает меньшую среднюю абсолютную ошибку.
MAE не устанавливает предел ошибки каждой отдельной оценки. Поэтому отдельно смотрят крупные промахи и группы объектов: районы, ценовые диапазоны, квартиры редких типов. Приемлемость ошибки зависит от использования результата: ориентир для предварительного сравнения и решение, принимаемое автоматически, требуют разной проверки.
Модель сравнивают с простым исходным способом прогнозирования. Для квартиры это может быть типичная цена по району, рассчитанная на обучающих данных; для продаж — значение аналогичного дня предыдущей недели. Все варианты проверяют на одинаковых объектах и с одной метрикой. Без такого сравнения сложно понять, дала ли сложная модель практический выигрыш.
R², коэффициент детерминации, оценивает качество относительно постоянного прогноза среднего целевого значения на проверяемой выборке. Для меняющихся целевых значений он может быть отрицательным, если модель хуже этого ориентира. R² не является процентом точности и не заменяет оценку ошибки в рублях или единицах товара.
Чем регрессия отличается от классификации и корреляции
Регрессия отвечает на вопрос о величине: «Какова цена квартиры?». Классификация в машинном обучении выбирает заранее заданную категорию: например, «требует ремонта» или «готова к заселению». Даже если эти категории записаны числами 0 и 1, задача остаётся классификацией: числа здесь служат кодами, а не измерением стоимости или площади.
Логистическая регрессия, несмотря на название, относится к методам классификации. Она оценивает вероятности категорий, по которым принимают решение о классе. В соседней статье разобраны эти решения и ошибки, возникающие при выборе порога.
Корреляция характеризует статистическую связь между величинами. Регрессионная модель задаёт способ оценить одну величину по другим. При этом ни найденная корреляция, ни сама по себе регрессия не доказывают причинность. Если квартиры с определённым оснащением дороже, это ещё не доказывает, что его установка увеличит цену именно на величину, которую предсказывает модель: различаться могут и другие характеристики жилья.
Когда прогноз полезен и какие есть ограничения
Регрессия полезна, когда числовая оценка помогает принять конкретное решение, доступны подходящие данные, а ошибка проверена в условиях, близких к будущему применению. Такой прогноз можно сравнить с простым правилом и со временем проверить повторно.
- Выбросы. Редкие крайние значения способны заметно влиять на некоторые модели и оценки ошибки. Их проверяют по смыслу, а не удаляют только ради красивого результата.
- Переобучение. Модель подстраивается под особенности обучающих примеров и хуже работает на новых. Разница между обучающей и независимой проверкой помогает заметить проблему.
- Утечка данных. Случайно доступный ответ или сведения из будущего делают проверку слишком оптимистичной. Нужно проверять происхождение каждого признака и момент его появления.
- Изменение условий. Новый ассортимент, изменение рынка или правил продаж могут ухудшить прогноз. После запуска продолжают сопоставлять оценки с фактическими результатами.
- Выход за пределы знакомых данных. Для незнакомого района может не оказаться подходящих примеров. Прогноз для площади за пределами изученного диапазона — пример экстраполяции. Число на выходе модели ещё не подтверждает его надёжность.
Перед использованием стоит определить допустимую ошибку, случаи ручной проверки и порядок действий при ухудшении качества. Тогда числовой прогноз становится проверяемой частью решения, а его ограничения остаются понятными.