Поиск ассоциативных правил
Богдан Немешаев · Опубликовано:
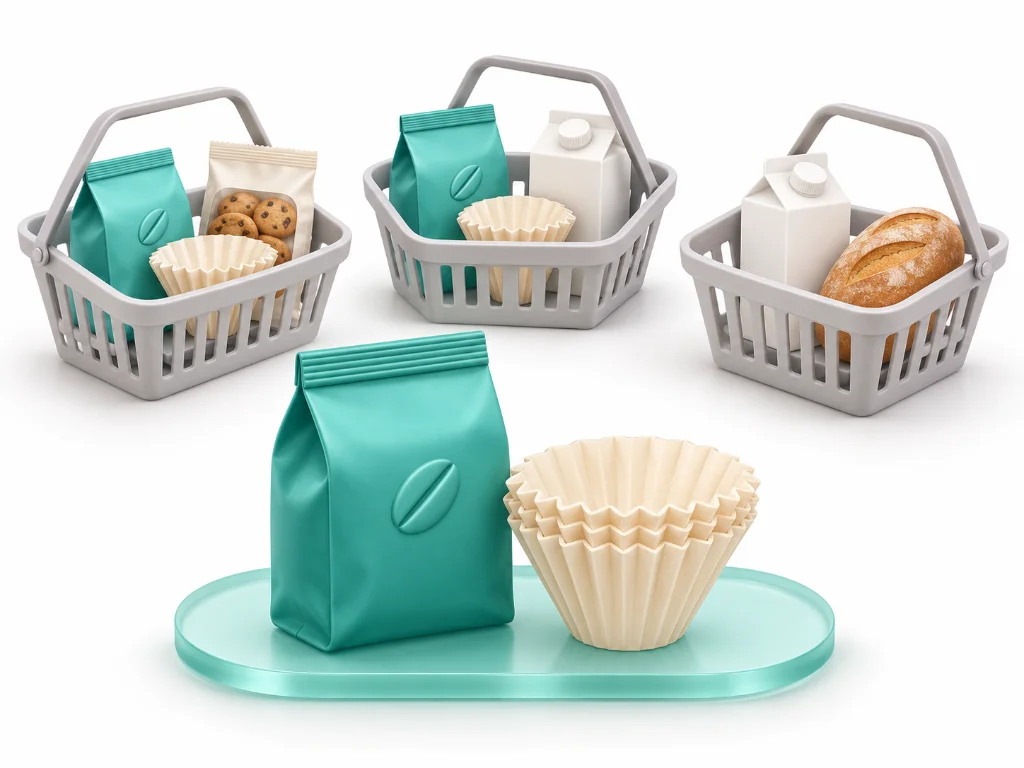
Какие товары покупают вместе и стоит ли предлагать их рядом? Поиск ассоциативных правил помогает обнаружить повторяющиеся сочетания в данных. Например, выяснить, насколько часто в корзине с кофе оказываются бумажные фильтры. Найденная связь даёт повод для проверки, но ещё не доказывает пользу рекомендации.
Разберём условные чеки небольшого магазина, найдём сочетания товаров и объясним поддержку, достоверность и лифт без формул. Затем посмотрим, как работают Apriori и FP-Growth и почему даже заметная связь может оказаться непригодной для практического решения.
Что такое ассоциативные правила
Ассоциативное правило описывает, какие элементы нередко встречаются вместе: если в записи есть одно сочетание, в ней часто оказывается и другое. В магазине записью может быть чек, а элементами — товары. Условие «в корзине есть кофе» помогает изучить, как часто в таких корзинах встречаются фильтры.
У правила есть условие и результат, который ищут среди записей с этим условием. Обе части могут содержать один или несколько товаров. Результат иногда называют следствием, но это название части правила, а не доказательство причины. Фраза «с кофе часто покупают фильтры» не означает, что кофе заставляет человека купить фильтры или что покупка происходит позже.
Это одна из задач обучения без учителя: мы не задаём правильный ответ для каждого чека, а ищем повторяющиеся сочетания. В отличие от классификации, здесь не требуется заранее размечать корзины по целевым категориям и учить модель их распознавать.
Не стоит путать такой анализ с кластеризацией. Она может объединить похожих покупателей в группы, а ассоциативные правила показывают совместную встречаемость товаров внутри покупок. Эти задачи отвечают на разные вопросы, хотя могут использовать одну историю заказов.
Пример: анализ покупательской корзины
Для учебного примера возьмём десять вымышленных чеков за один период. Одна строка — одна завершённая покупка. Пока учитываем только присутствие товара: две пачки кофе в одном чеке не превращают его в две корзины. Такой подход называют анализом покупательской корзины, или market basket analysis.
| Чек | Товары в корзине |
|---|---|
| 1 | Кофе, бумажные фильтры, печенье |
| 2 | Кофе, бумажные фильтры |
| 3 | Кофе, бумажные фильтры, молоко |
| 4 | Кофе, печенье |
| 5 | Бумажные фильтры, чай |
| 6 | Бумажные фильтры, печенье |
| 7 | Чай, печенье |
| 8 | Молоко, хлеб |
| 9 | Чай, хлеб |
| 10 | Молоко, печенье |
Кофе встречается в четырёх чеках, бумажные фильтры — в пяти, а вместе они есть в трёх. Кофе с печеньем встречаются в двух чеках. Уже видны разные сочетания, но одного подсчёта пар недостаточно: нужно учитывать, насколько часто каждый товар покупают вообще.
Частый набор элементов — сочетание, которое встречается не реже выбранного порога. Если только для этой иллюстрации считать достаточными два чека из десяти, обе пары пройдут отбор. Это не универсальный порог для магазина: десяти наблюдений слишком мало для уверенного решения.
Из пары кофе и фильтров можно получить правило: «Среди корзин с кофе часто встречаются бумажные фильтры». Его возможное применение — проверить предложение подходящих фильтров тем, кто добавил кофе, но ещё не положил фильтры в корзину. Нужно учесть наличие товара и способ приготовления: бумажные фильтры нужны не каждому покупателю кофе.
Таким образом, вход — состав чеков, найденный результат — повторяющееся сочетание, а следующее действие — проверка конкретного предложения. Алгоритм не знает, нужна ли человеку эта покупка и выгодно ли магазину показывать рекомендацию.
Как понять, полезно ли правило
Три основные метрики отвечают на разные вопросы. Разберём правило о фильтрах в корзинах с кофе на тех же десяти чеках.
| Метрика | Значение | Как прочитать результат |
|---|---|---|
| Поддержка | 30% | В трёх из десяти корзин есть и кофе, и фильтры. Это доля сочетания среди всех покупок. |
| Достоверность | 75% | Среди четырёх корзин с кофе три содержат фильтры. Здесь рассматриваем только покупки, где выполнено условие. |
| Лифт | 1,5 | Фильтры есть в 50% всех корзин, а среди корзин с кофе — в 75%. Во второй группе их доля в полтора раза выше обычной. |
Поддержка, или support, показывает распространённость всего сочетания. Она помогает отличить регулярно встречающийся набор от единичного случая. Вместе с долей важно смотреть на число наблюдений: одинаковый процент на десяти и на нескольких тысячах чеков даёт разный объём информации.
Достоверность, или confidence, показывает долю записей с результатом среди записей с условием. Вопреки названию, это не уверенность в истинности правила и не вероятность успеха будущего предложения. Направление важно: в обратном правиле, о кофе среди корзин с фильтрами, достоверность будет 60% — кофе есть в трёх из пяти таких корзин.
Лифт, или lift, учитывает обычную популярность результата. Значение больше единицы указывает, что сочетание встречается чаще, чем ожидалось бы при независимости товаров; около единицы — заметного превышения нет; меньше единицы — сочетание встречается реже такого ожидания. Сам по себе лифт не доказывает устойчивость связи на новых данных.
Сравним с печеньем. Оно встречается в пяти из десяти чеков и в двух из четырёх чеков с кофе. Достоверность правила о печенье среди покупок кофе — 50%, но это та же доля, что и среди всех корзин. Лифт равен 1: в этом примере кофе не выделяет покупки, где печенье встречается чаще обычного.
Выбирать правило по одной самой большой цифре опасно. Высокий лифт бывает у редких совпадений, а высокая достоверность — у повсеместно популярного товара. Нужны достаточное число наблюдений, проверка на другом периоде и понятный сценарий применения. Универсальных порогов поддержки, достоверности и лифта для всех задач нет.
Как ищут правила: Apriori и FP-Growth
Когда товаров много, вручную перебрать все сочетания невозможно. Алгоритмы сначала находят частые наборы элементов, а затем из них формируют правила и отбирают подходящие по метрикам. Это инструменты анализа данных, которые рассматривают среди методов классического машинного обучения.
Apriori движется от простого к сложному: от отдельных товаров к парам, затем к более длинным наборам. Он использует понятное свойство: если кофе с фильтрами встречаются слишком редко, добавление к ним ещё одного товара не сделает сочетание более частым. Такие расширения можно не проверять. Но при большом ассортименте и длинных корзинах кандидатов всё равно может быть очень много.
FP-Growth представляет повторяющиеся части корзин в виде компактного дерева. Общие части записей используются совместно, а частые сочетания ищутся в этой структуре без явного построения такого списка кандидатов, как у Apriori. Подход часто удобен для больших наборов с повторяющимися сочетаниями, однако расход памяти и скорость зависят от самих данных и настроек.
Оба алгоритма решают задачу поиска частых наборов, а не доказывают полезность найденного правила. При одинаковых данных и пороге частоты они должны находить одни и те же частые наборы. Выбор способа расчёта меняет затраты на поиск, но не отменяет проверку качества исходных данных и практического смысла результата.
Где применяют ассоциативные правила
Сопутствующие предложения. Найденное сочетание помогает выбрать кандидата для блока «часто покупают вместе». До показа учитывают совместимость, остатки и уже добавленные товары. Правило может быть частью рекомендательной системы, но не заменяет все её механизмы и не описывает личные предпочтения каждого посетителя.
Анализ ассортимента. Повторяющиеся совместные покупки помогают заметить товары, которые покупателю может быть удобно найти рядом или включить в один набор. После этого проверяют, нужен ли такой набор на практике и не объясняется ли сочетание уже существующей акцией.
Сочетания событий вне торговли. Например, каждую рабочую смену одного устройства можно описать набором зарегистрированных предупреждений. Повторяющиеся сочетания дадут специалисту направление для диагностики. Они не установят, какое предупреждение появилось первым и что стало причиной сбоя: для этого нужны время событий и отдельное исследование.
Все эти сценарии — примеры возможного применения, а не обещания результата. Для магазина недостаточно показать, что люди уже покупают два товара вместе. Нужно отдельно выяснить, даёт ли новое предложение дополнительную пользу по сравнению с привычным способом работы.
Какие данные нужны
Минимальная основа — набор записей, каждая из которых содержит список совместно наблюдаемых элементов. В торговле это номер чека и товары в нём; для проверки сезонности и условий продаж понадобятся также период, канал и сведения об акциях.
- Одинаковая единица анализа. Заранее определяют, что считается корзиной: один заказ, чек или посещение. Покупки человека за год не равнозначны товарам в одном заказе — объединение изменит смысл правила.
- Единообразные названия. Один товар под разными кодами искусственно дробит статистику. Объединение вариантов в общую категорию тоже должно быть осмысленным: связь на уровне «кофе» не гарантирует такую же связь для каждой марки.
- Корректный состав покупки. Удаляют случайные дубли одной записи, разбирают пропуски, заранее определяют учёт отмен и возвратов. Неизвестный состав корзины нельзя считать отсутствием товаров.
- Понятные правила подсчёта. В нашем примере важен факт присутствия товара, а не число упаковок, сумма заказа или порядок добавления. Для других вопросов данные нужно готовить иначе.
- Достаточная и подходящая история. Проверяют не только число чеков, но и то, какие покупатели и условия в них представлены. Множество заказов нескольких постоянных клиентов не обязательно описывает поведение всей аудитории.
Совместная встречаемость и последовательность событий — разные задачи. Обычная корзина показывает, что кофе и фильтры попали в одну покупку, но не говорит, какой товар человек выбрал первым или что он купит в следующий раз. Для таких вопросов нужны данные о времени и другая постановка анализа.
Ограничения: связь не означает причину
Совместная встречаемость не доказывает причинную связь. Кофе и фильтры могли попасть в один чек из-за общей потребности, скидки на комплект или расположения товаров. Из самого правила нельзя заключить, что показ фильтров вызовет дополнительную покупку.
- Популярность товара. То, что покупают почти все, часто оказывается рядом с любыми другими товарами. Поэтому достоверность рассматривают вместе с обычной частотой результата и лифтом.
- Редкие сочетания. Несколько совпадений могут дать впечатляющую метрику, но исчезнуть при добавлении новых чеков. Нужно видеть исходные количества, а не только доли.
- Акции и сезонность. Правило, найденное во время распродажи или праздника, может не работать в обычные дни. Онлайн-заказы и покупки в разных магазинах тоже не всегда стоит смешивать.
- Большое число проверок. При поиске тысяч правил часть связей выглядит интересной случайно. Отбор на прошлых покупках нужно дополнять проверкой на новых данных, которые не использовали для подбора правил.
Проверка проходит на двух уровнях. Сначала выясняют, сохраняется ли сочетание в другом сопоставимом периоде и нет ли ошибок в данных. Затем проверяют само действие: например, сравнивают предложение сопутствующего товара с отсутствием такого предложения в контролируемом эксперименте. Учитывают не только покупки, но и скидки, возвраты и удобство пользователя.
Полезный итог анализа — короткий список понятных гипотез с известными данными, метриками и способом проверки. Поддержка, достоверность и лифт помогают выбрать, что изучать дальше, но не превращают наблюдаемую связь в причину или гарантию роста продаж.