Уменьшение размерности
Богдан Немешаев · Опубликовано:
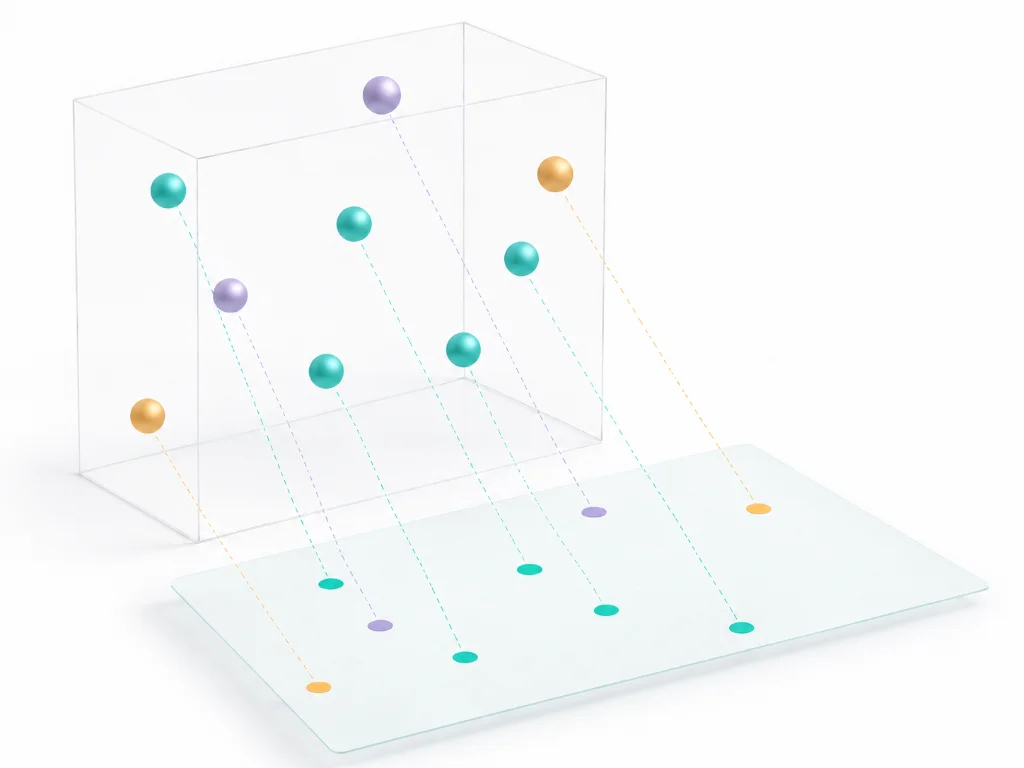
У объекта могут быть десятки или сотни характеристик. Уменьшение размерности помогает заменить такое описание более компактным: например, представить каждый товар двумя числами и расположить товары на плоскости. Объекты остаются теми же, но часть различий между ними может потеряться.
Разберём переход от характеристик ноутбуков к двум координатам, назначение PCA, t-SNE и UMAP и отличие от отбора признаков. Главное — не просто получить меньше столбцов, а проверить, осталось ли в них то, что нужно для дальнейшей задачи.
Что такое уменьшение размерности
Размерность данных — число признаков, которыми мы описываем объект. Если для товара записаны масса, цена и объём памяти, его описание содержит три признака. Добавим ещё двадцать характеристик — размерность увеличится, хотя сам товар не изменится.
Уменьшение размерности, также снижение или понижение размерности, — переход к описанию с меньшим числом признаков. Здесь речь прежде всего о построении новых обобщённых признаков из исходных. Это не уменьшение физических размеров товара и не удаление части строк из таблицы.
В машинном обучении многие методы уменьшения размерности относятся к обучению без учителя: для преобразования не нужны заранее известные категории или правильные прогнозы. Метод изучает устройство самих данных. Полученное представление затем можно использовать и в задачах обучения с учителем.
Переход похож на краткое описание вместо подробной анкеты: с ним удобнее работать, но оно не передаёт всех деталей. Какие свойства сохранять — общий разброс значений, ближайших соседей или пользу для следующей модели — зависит от метода и цели.
Зачем снижать размерность
- Рассмотреть сложные данные. Две координаты позволяют показать объекты точками на плоскости. Это помогает заметить похожие записи и необычные наблюдения, а затем изучить их исходные характеристики.
- Сократить описание. Часть признаков может повторять похожие различия. Например, несколько показателей размеров товара иногда меняются согласованно, и их можно представить компактнее.
- Подготовить данные для анализа. Более короткое описание иногда уменьшает шум или затраты следующей модели. Но само преобразование тоже требует времени и памяти, поэтому ускорение нужно измерять.
С большим числом признаков связана проблема, которую называют проклятием размерности. Возможных сочетаний характеристик становится так много, что имеющиеся наблюдения покрывают лишь малую их часть. Найти действительно похожие объекты труднее, особенно когда много признаков не относится к задаче.
Уменьшение размерности может помочь, но не заменяет качественные данные. Если редкая характеристика важна для решения, её потеря будет вреднее, чем экономия нескольких столбцов.
Пример: от характеристик ноутбуков к двум координатам
Представим каталог техники. Для каждого ноутбука доступны десятки характеристик. Чтобы показать сам переход, возьмём шесть вымышленных ноутбуков и шесть числовых признаков. Это учебный набор, а не результаты исследования реального магазина; для практических выводов шести объектов недостаточно.
| Ноутбук | Экран, дюймы | Масса, кг | Память, ГБ | Накопитель, ГБ | Ядра процессора | Работа от батареи, ч |
|---|---|---|---|---|---|---|
| А | 13,3 | 1,1 | 8 | 256 | 4 | 12 |
| Б | 14 | 1,4 | 16 | 512 | 8 | 10 |
| В | 15,6 | 2,2 | 8 | 512 | 6 | 7 |
| Г | 16 | 2,4 | 32 | 1024 | 12 | 6 |
| Д | 14 | 1,5 | 32 | 1024 | 8 | 11 |
| Е | 17,3 | 2,7 | 16 | 512 | 12 | 5 |
Сначала приведём столбцы к сопоставимому масштабу: для каждого признака учтём его среднее значение и обычный разброс. Это стандартная подготовка, которая не даёт сотням гигабайт перевесить единицы килограммов только из-за единиц измерения. Затем применим метод главных компонент, PCA, и оставим две компоненты.
| Ноутбук | Компонента 1 | Компонента 2 |
|---|---|---|
| А | −3,14 | −0,61 |
| Б | −1,24 | 0,12 |
| В | −0,05 | −1,46 |
| Г | 2,46 | 1,13 |
| Д | −0,46 | 2,28 |
| Е | 2,43 | −1,47 |
Ноутбуков по-прежнему шесть. Изменилось их описание: у каждого теперь два числа, по которым можно поставить точку на плоскости. Это не цена и не оценка качества; отрицательная координата не означает плохой ноутбук.
В этом примере первая компонента в основном отделяет более крупные и тяжёлые устройства с меньшим временем работы от лёгких и автономных. На вторую заметно влияют память и объём накопителя. Такие пояснения человек даёт после изучения вклада исходных признаков: алгоритм не присваивает осям готовые названия вроде «качество» или «выгодная покупка».
Например, Г и Е имеют близкую первую координату, но расходятся по второй. Одной оси было бы недостаточно, чтобы показать различия между ними. Даже две оси не сохраняют всё: по ним нельзя точно восстановить каждую характеристику из исходной таблицы.
Как использовать результат
На большом каталоге такая карта помогает выбирать похожие товары для подробного сравнения. Но близость точек ещё не означает взаимозаменяемость: у ноутбуков могут различаться разъёмы, совместимость или другие неучтённые свойства. Исходные характеристики нужно сохранить и проверять.
Компактные признаки также можно передать алгоритму кластеризации, модели классификации или регрессии. Например, использовать их для прогноза цены. Тогда цену не включают в преобразуемые входные признаки: это ответ, который модель должна научиться предсказывать.
Другие примеры — исследование документов по числовым описаниям текста, сравнение изображений и анализ показаний множества датчиков. Для визуализации удобно оставить две или три координаты; для следующей модели их может понадобиться гораздо больше. Не нужно сжимать данные до плоской картинки любой ценой.
Основные методы: PCA, t-SNE и UMAP
Методы снижения размерности различаются тем, какие отношения в данных стараются сохранить. Поэтому результат одного метода нельзя автоматически считать заменой результата другого.
PCA — метод главных компонент
PCA строит новые признаки как сочетания исходных и выбирает направления, в которых значения различаются сильнее всего. Первые компоненты сохраняют больше общего разброса. Это понятная отправная точка для компактного числового описания, особенно когда исходные признаки меняются согласованно.
Но большой разброс не равен важности для задачи. Небольшое изменение показателя может отличать исправное устройство от неисправного, а PCA не знает, что именно эту деталь нужно сберечь. Нужны подготовка масштаба, проверка выбросов и оценка последующей модели.
t-SNE — рассмотреть ближайшее окружение объектов
t-SNE прежде всего используют для визуализации многомерных данных. Метод старается разместить похожие объекты рядом и показать локальное соседство. Например, помочь исследователю рассмотреть числовые описания изображений.
Расстояния между далёкими группами на такой картинке нельзя буквально читать как исходную степень различия. Видимые островки не доказывают существование отдельных классов. Раскладка зависит от настроек и начального расположения точек; красивый рисунок сам по себе не подтверждает качество данных.
UMAP — компактное представление через связи между соседями
UMAP сначала описывает связи между близкими объектами, а затем строит более компактное представление, стараясь эти связи сохранить. Его используют и для визуализации, и для подготовки признаков; число новых координат не обязано быть равно двум.
У UMAP есть средства переноса новых объектов в уже построенное представление. Это полезно для дальнейшей модели, но не гарантирует сохранения всех расстояний и плотности групп. Настройки и выбор признаков могут заметно менять результат.
Есть и другие подходы. Усечённое SVD используют, например, для компактного представления больших таблиц «документ — слово», в которых много нулей. Автоэнкодер — нейросеть, которая учится восстанавливать входные данные через промежуточное короткое описание. Сложность метода сама по себе не делает представление полезнее: выбор всё равно проверяют на задаче.
Чем уменьшение размерности отличается от отбора признаков
При отборе признаков сохраняют часть исходных столбцов. Например, из таблицы ноутбуков оставляют массу, память и время работы от батареи. Значение каждого признака остаётся привычным: килограммы, гигабайты или часы.
При построении компактного представления появляются новые признаки. Две компоненты из нашего примера — не два выбранных столбца, а сочетания исходных характеристик. Их труднее объяснить, зато они могут объединить информацию из нескольких столбцов.
В широком смысле отбор тоже уменьшает размерность, потому что сокращает число признаков. Различие — в способе: оставить часть готовых характеристик или преобразовать их в новые. Иногда достаточно удалить повторяющиеся и ненужные столбцы, не вводя дополнительные методы.
Как выбрать метод и проверить результат
Сначала определяют цель. Для знакомства с данными важны понятная визуализация и сохранение соседства, для прогноза — ошибка на новых объектах, для экономии ресурсов — время и память всего процесса.
- Проверить исходные данные. Устранить ошибки и дубликаты, разобраться с пропусками и единицами измерения. Масштабировать признаки осмысленно: само совпадение числовых диапазонов ещё не делает характеристики одинаково важными.
- Сравнить с исходным вариантом. Проверить решение без уменьшения размерности, с простым отбором признаков и с новым представлением. Использовать одинаковые условия проверки и учитывать стоимость самого преобразования.
- Подобрать число новых признаков. Для PCA можно посмотреть, какая часть общего разброса сохранена; её называют объяснённой дисперсией. Но высокая доля не доказывает, что сохранена информация для нужного прогноза. Число компонент выбирают с учётом задачи.
- Проверить соседство и устойчивость. Взять несколько объектов, найти их соседей до и после преобразования и сравнить. Повторить исследование с другими разумными настройками и посмотреть, не исчезают ли важные закономерности.
- Оценить следующий шаг. Для классификации изучить ошибки по нужным классам, для регрессии — отклонения прогноза, для кластеризации — смысл и устойчивость групп. Одной привлекательной картинки недостаточно.
Если далее строится модель с учителем, сначала разделяют данные на обучающую часть и данные для проверки. Масштабирование и само преобразование обучают только на обучающей части. К проверочным объектам применяют уже найденные правила, иначе сведения из проверки попадут в обучение и оценка окажется завышенной.
Настройки и число компонент подбирают на валидационных данных, а итог оценивают на отдельной тестовой части. При повторных разбиениях заново обучают весь процесс внутри каждого разбиения. Для новых объектов нужен способ получить координаты в том же представлении: отдельный запуск t-SNE на другой выборке не создаёт автоматически совместимые признаки.
Полезный результат — не обязательно максимальное сжатие. Иногда стоит оставить больше компонент, сохранить отдельный важный признак или вовсе отказаться от преобразования, если исходная модель решает задачу лучше.
Когда уменьшение размерности может навредить
- Теряется редкий, но важный сигнал. Отличие нескольких неисправных устройств может почти не влиять на общий разброс, хотя именно его нужно обнаружить.
- Становится труднее объяснить решение. Сочетание нескольких характеристик менее понятно человеку, чем масса или число часов работы.
- Картинка вводит в заблуждение. Близкие точки могут различаться по отброшенным свойствам, а видимые группы — меняться при другой настройке отображения.
- Данные меняются со временем. Новые типы товаров могут плохо укладываться в прежнее представление. Нужно повторно проверять качество и при необходимости переобучать преобразование.
В примере с ноутбуками две координаты удобны для обзора, но не заменяют карточку товара. Аналогично компактное описание клиентов, документов или сигналов датчиков не становится готовым решением только потому, что занимает меньше места.
Более компактное представление не обязательно улучшает качество модели. Уменьшение размерности полезно, когда сохраняет нужные различия и помогает конкретному следующему шагу. Это подтверждают сравнением на данных, а не количеством удалённых столбцов.