Кластеризация в машинном обучении
Богдан Немешаев · Опубликовано:
Одни покупатели заказывают часто и понемногу, другие — редко, но на большую сумму. Если готовых категорий нет, кластеризация помогает найти похожие группы по данным. Алгоритм предлагает разделение, а человек выясняет, что объединяет участников и для чего результат можно использовать.
Разберём, как устроена такая группировка, чем она отличается от классификации и как проверить её смысл. На условном примере магазина пройдём путь от истории покупок до возможных действий для разных групп.
Что такое кластеризация данных
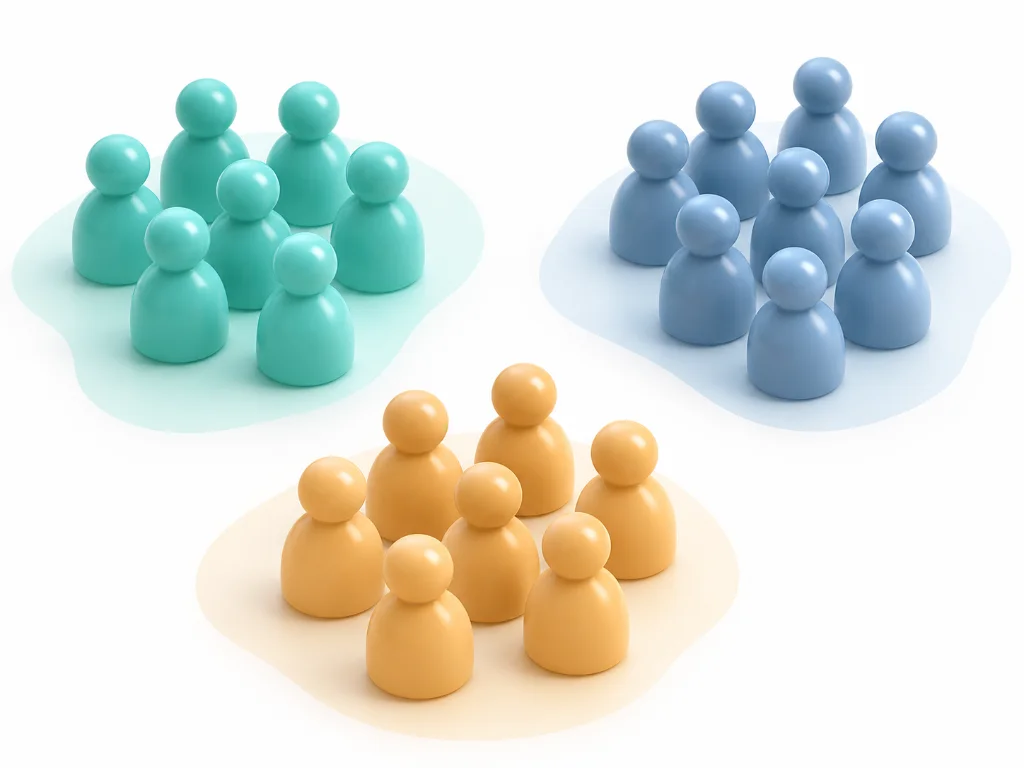
Кластеризация — задача поиска групп похожих объектов. Отдельную группу называют кластером. Объектом может быть покупатель, документ или запись датчика, а признаками — характеристики, по которым их сравнивают. Например, покупателей можно описать числом заказов, средним чеком и давностью последней покупки.
Это одна из задач обучения без учителя: в исходных примерах нет целевых меток, которые указывали бы правильную группу для каждого объекта. Алгоритм ищет структуру в выбранных признаках, а не учится воспроизводить готовое распределение по категориям.
Сходство зависит от постановки задачи. Покупатели с близкими расходами могут предпочитать совершенно разные товары. Если сравнивать состав корзины вместо суммы, группы изменятся. Поэтому кластерный анализ не обнаруживает единственные правильные типы объектов: он предлагает способ посмотреть на данные с определённой стороны.
Для чего нужна кластеризация
Кластеризация полезна, когда отдельных наблюдений много, а понятной структуры ещё нет. Вместо просмотра каждой записи можно начать с групп и затем изучить характерные и спорные случаи внутри них.
- Исследовать покупателей. Найти разные способы совершать покупки и проверить, нужны ли группам разные предложения или условия обслуживания.
- Разбирать документы и обращения. Объединить похожие тексты, чтобы увидеть повторяющиеся темы и подготовить будущую систему рубрик.
- Изучать работу оборудования. Сгруппировать похожие режимы по показаниям датчиков и отдельно рассмотреть нетипичные наблюдения.
- Анализировать операции. Найти похожие по характеристикам записи, а необычные передать на проверку. Отличие от остальных само по себе не доказывает ошибку или нарушение.
Это возможные сценарии, а не результаты конкретных внедрений. Не всякая сегментация требует машинного обучения: если магазин заранее делит клиентов по установленным порогам суммы заказа, это группировка по правилам. Кластеризация нужна тогда, когда разделение хотят найти в самих данных.
Пример: как сгруппировать покупателей
Представим магазин, который хочет понять, насколько различается покупательское поведение. Для каждого клиента соберём оплаченные заказы за последние 90 дней: их количество, средний чек и число дней с последней покупки до общей даты анализа. Отменённые заказы не будем считать покупками; правила учёта возвратов определим заранее.
В таблице — шесть вымышленных покупателей. Числа и дальнейшая группировка служат учебной иллюстрацией, а не отчётом о расчёте на реальной базе. Отметок «частый» или «редкий» в исходных данных нет.
| Покупатель | Число заказов | Средний чек, ₽ | Дней с последней покупки |
|---|---|---|---|
| 1 | 12 | 1 200 | 3 |
| 2 | 10 | 1 400 | 5 |
| 3 | 3 | 9 000 | 8 |
| 4 | 2 | 11 000 | 12 |
| 5 | 1 | 1 600 | 70 |
| 6 | 1 | 1 800 | 80 |
До группировки нужно привести признаки к сопоставимому масштабу: тысячи рублей не должны автоматически перевешивать количество заказов и дни. Затем можно попробовать несколько вариантов разделения. Допустим, после такой подготовки получили следующие три группы. Здесь число три выбрано для наглядности, а не как рекомендация для любого магазина.
| Группа | Что видно в данных | Что можно проверить |
|---|---|---|
| Покупатели 1 и 2 | Частые покупки с небольшим средним чеком; последние заказы сделаны недавно. | Удобен ли повторный заказ привычных товаров и нужен ли такой группе другой формат напоминаний. |
| Покупатели 3 и 4 | Заказов немного, средний чек заметно выше; покупки тоже были недавно. | Востребованы ли консультация перед покупкой и подбор сопутствующих товаров. |
| Покупатели 5 и 6 | По одной покупке за период, после неё прошло много времени. | Есть ли потребность вернуться и уместно ли напоминание с учётом обычного цикла покупки. |
Названия и объяснения появились после группировки. Алгоритм не сообщил, что одни клиенты «лояльные», а другие «потерянные». Частые покупки не раскрывают отношение к магазину, а большой чек — доход человека. Для третьей группы стоит выяснить, что покупали клиенты и как давно зарегистрировались: долгий перерыв может быть нормальным для товара, который нужен редко.
Возможные действия остаются гипотезами. Магазину нужно проверить, помогает ли отдельное предложение лучше обычного подхода, например сравнить результаты на сопоставимых группах с предложением и без него. По самой таблице нельзя обещать рост повторных заказов или выручки.
Если добавить категории товаров, прежние группы могут разделиться иначе: покупатели с разным чеком окажутся рядом из-за общих интересов. Полезность такого варианта зависит от цели. Для планирования частоты сообщений важен ритм покупок, для подбора ассортимента — состав корзины.
Похожий принцип работает с документами. Обращения сначала переводят в числовое представление содержания, затем группируют по сходству и читают примеры из каждой группы. Так можно заметить темы доставки или возврата. Но одинаковый шаблон письма тоже способен объединить тексты, поэтому название темы требует проверки человеком.
Какие данные подготовить
Качество кластеризации начинается с выбора того, что считать похожим. Большое число столбцов не заменяет осмысленные признаки: случайные или дублирующие характеристики могут скрыть полезные различия.
- Определить объект и период. Одна строка должна описывать одного покупателя по одинаковым правилам. Историю за три месяца нельзя без поправок сравнивать с историей за неделю. Клиентов без покупок за выбранный период нужно учитывать отдельно или заранее определить, как их описывать.
- Проверить пропуски и ошибки. Отсутствующая сумма не равна нулевой. Повторно загруженные заказы, неверная валюта или ошибочная дата способны создать искусственные группы.
- Учесть масштаб и выбросы. Рубли, дни и количество заказов имеют разные диапазоны. Необычно крупную покупку сначала проверяют: это может быть как ошибка, так и важный реальный случай. Удалять все отличающиеся записи нельзя.
- Подготовить категории и текст. Номер клиента не описывает его поведение. Название товара и текст обращения тоже нельзя просто считать числовыми координатами: нужно подходящее представление и способ сравнения.
Полезно сохранить правила подготовки данных, чтобы повторить анализ в следующем месяце. Если изменились период, признаки или их масштаб, отличие новых групп от прежних может объясняться подготовкой, а не поведением покупателей.
Основные методы: k-means, DBSCAN и иерархическая кластеризация
Методы кластеризации по-разному понимают форму группы. Поэтому алгоритм выбирают под данные и задачу, а не по названию или популярности. Эти подходы относятся к инструментам классического машинного обучения.
k-means, или метод k-средних, собирает объекты вокруг центров групп. Каждый центр описывает усреднённый набор признаков своих участников. Число кластеров задают заранее; затем алгоритм уточняет центры и распределение объектов. Такой подход удобно пробовать на числовых данных, когда ожидаются достаточно компактные группы сопоставимого размера.
Метод k-средних чувствителен к масштабу признаков, выбросам и начальному выбору центров. Он может неудачно разделить вытянутые или сильно различающиеся по плотности группы. Кроме того, каждый объект попадёт в какой-либо кластер, даже если он мало похож на остальных.
DBSCAN ищет плотные области: места, где у объектов достаточно близких соседей. Он может находить группы сложной формы и оставлять отдельные наблюдения вне кластеров как шум. Число групп заранее не задают, зато настраивают, какое расстояние считать небольшим и сколько соседей нужно для плотной области.
Результат DBSCAN сильно зависит от этих настроек и способа измерять расстояние. Единое требование к плотности может плохо подходить данным, в которых одна группа густая, а другая разреженная. Пометка «шум» означает только отсутствие подходящей группы при выбранных настройках, а не доказанную ошибку в записи.
Иерархическая кластеризация показывает вложенные объединения объектов. В агломеративном варианте каждый объект сначала составляет отдельную группу, а затем наиболее близкие группы постепенно соединяются. Получается дерево: его можно рассматривать на разных уровнях детализации и выбирать более крупное или более мелкое разделение.
Иерархический подход полезен для исследования структуры, но результат зависит от того, как измеряют близость групп и на каком уровне останавливают объединение. Для больших наборов данных расчёт и хранение расстояний могут оказаться затратными. Универсального победителя среди этих методов нет: несколько разумных вариантов сравнивают на одних и тех же подготовленных данных.
Как выбрать число кластеров и проверить качество
Единственного правильного числа кластеров может не быть. Две большие группы подходят для общего обзора, а более подробное разделение — для разбора отдельных сценариев. В k-means проверяют несколько вариантов числа групп, в иерархическом методе — уровни объединения, а в DBSCAN смотрят, как настройки меняют состав кластеров и долю шума.
Метод локтя помогает оценить, насколько увеличение числа групп улучшает их компактность, например при использовании k-means. На графике ищут место, после которого добавление новых кластеров даёт уже небольшой выигрыш. Однако отчётливого «локтя» может не быть, а заметный изгиб ещё не доказывает, что разделение полезно для задачи.
Силуэт, или silhouette, оценивает, насколько объект близок к своей группе по сравнению с ближайшей соседней. Это пример внутренней метрики: для неё не нужны правильные метки. Но она зависит от выбранного расстояния и лучше подходит некоторым формам групп, чем другим. Её значение нельзя читать как процент правильно распределённых покупателей.
Внешние метрики используют, если есть независимое эталонное разделение, например проверенная экспертами разметка документов. Тогда сравнивают состав групп, а не совпадение их условных номеров. Важно, чтобы эталон отвечал той же задаче: темы документов и стиль их написания могут дать разные, но осмысленные группировки.
Одной метрики недостаточно. Чтобы проверить результат, полезно пройти ещё три шага:
- Изучить состав. Посмотреть размеры групп, характерные объекты и случаи на границах. Средние значения не должны скрывать совершенно разных участников. Понятное название группы нужно подтверждать её содержимым.
- Проверить устойчивость. Повторить расчёт с другими начальными условиями, небольшими изменениями выборки и на сопоставимом периоде. Если группы каждый раз меняются без понятной причины, строить на них постоянные действия рискованно. Сравнивают участников и характеристики, а не номера кластеров.
- Проверить применение. Убедиться, что разделение помогает решить исходную задачу лучше простых правил или общего подхода для всех. Хорошая внутренняя метрика сама по себе не доказывает коммерческую пользу.
Если качество не устраивает, сначала проверяют признаки, пропуски, масштаб и спорные объекты, а затем меняют метод или настройки. Иногда полезнее отказаться от искусственного деления: данные могут образовывать плавный переход, а не отчётливо разделённые группы.
Чем кластеризация отличается от классификации
При кластеризации группы обнаруживают по сходству объектов. При классификации категории задают заранее, а модель учится определять их по размеченным примерам. Это различие в постановке задачи, а не просто два названия группировки.
Допустим, у поддержки нет готового перечня тем. Кластеризация обращений помогает исследовать, о чём пишут клиенты. Если же рубрики «доставка», «оплата» и «возврат» уже определены и есть проверенные примеры, можно обучать классификатор для распределения новых сообщений. Такой сценарий относится к обучению с учителем.
Один подход может подготовить работу для другого. Найденные кластеры изучают, уточняют будущие категории и размечают примеры. Но автоматически превращать номера кластеров в правильные ответы нельзя: группа может смешивать разные темы или разделять одну тему по несущественному признаку.
Когда результат полезен и где возможны ошибки
Кластеризация полезна, если группы помогают понять данные или проверить конкретное действие. Красивой схемы с несколькими цветами недостаточно: нужно объяснить, почему объекты оказались рядом и что даёт такое разделение.
- Неудачные признаки. Группы могут отражать формат выгрузки, канал сбора данных или ошибки учёта вместо интересующего поведения.
- Слабые границы. Похожие объекты иногда попадают в разные группы, а промежуточные случаи плохо укладываются в любое разделение. Жёсткая граница не всегда соответствует реальному различию.
- Избыточная интерпретация. Кластеры покупателей не являются постоянными типами людей и не объясняют причины их поступков. Выводы о мотивах требуют других данных и отдельной проверки.
- Изменение условий. Сезон, ассортимент и способы оплаты меняют поведение. Старые группы могут потерять смысл, поэтому их состав и полезность периодически пересматривают.
Практический результат — не просто список номеров кластеров, а понятное описание групп, границ применимости и следующего шага проверки. Тогда кластеризация становится инструментом исследования и принятия решений, а не способом навязать данным заранее желаемую картину.