Обучение без учителя
Богдан Немешаев · Опубликовано:
У магазина накопилась история покупок, но никто заранее не отметил, какие покупатели похожи и какие товары связаны между собой. Обучение без учителя помогает исследовать такие данные: находить группы, частые сочетания и более компактное описание объектов.
Разберём подход на условном примере магазина и покажем, что человек должен проверить перед использованием результата. Все примеры в статье учебные: они объясняют возможные сценарии, а не описывают реальные внедрения.
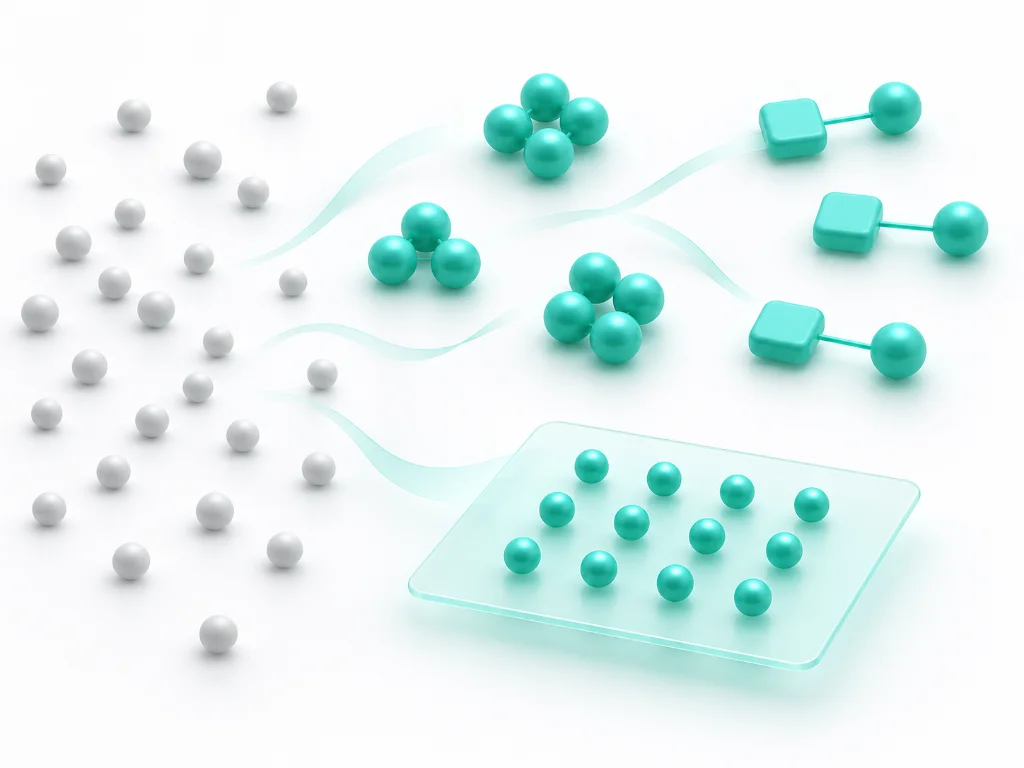
Схема обучения без учителя
Нажмите на блок, чтобы перейти к пояснению. На узком экране прокручивайте схему внутри рамки. С клавиатуры выбирайте блоки клавишей Tab и переходите клавишей Enter.
Что такое обучение без учителя
Обучение без учителя, по-английски unsupervised learning, — подход в машинном обучении, при котором алгоритм ищет структуру в данных без заранее заданных целевых ответов для каждого примера. Простыми словами, мы показываем, что известно об объектах, но не указываем, какой ответ модель должна выдать для каждого из них.
В нашем магазине объектом может быть покупатель, а его признаками — частота заказов, обычная сумма покупки и интерес к разным категориям товаров. В таблице нет готовой отметки «этот покупатель относится к такой-то группе». Алгоритм сравнивает описания покупателей по выбранному правилу и предлагает группировку.
Такие данные часто называют неразмеченными. Это не означает, что в них нет названий товаров, дат или категорий. Отсутствуют именно целевые ответы для выбранной задачи. Например, категория товара может быть входным признаком, даже если группы покупателей ещё неизвестны.
«Без учителя» не означает «без человека». Специалист формулирует вопрос, выбирает признаки, готовит данные и настраивает метод. После расчёта он изучает найденные группы или связи и решает, имеют ли они практический смысл. Алгоритм сам не знает, какую задачу магазина нужно улучшить.
Этот подход входит в классическое машинное обучение, но применяется и в нейросетях. Общую картину направлений можно посмотреть в статье «Технологии искусственного интеллекта».
Какие задачи решает обучение без учителя
Начинать стоит с вопроса к данным. Нужно найти похожих покупателей, увидеть товары, которые встречаются вместе, или упростить описание каждого покупателя? Эти вопросы ведут к разным результатам и требуют разных методов.
Для кластеризации используют, например, алгоритм k-средних, для поиска частых сочетаний — Apriori, для уменьшения размерности — метод главных компонент, или PCA. Это примеры инструментов, а не последовательные этапы одного обязательного процесса. Универсального лучшего алгоритма нет: выбор зависит от данных и того, как будет использоваться результат.
Нейросети также могут обучаться без внешней разметки. Например, автоэнкодер учится восстанавливать входные данные через внутреннее представление, которое можно сделать компактным. Здесь важно назначение подхода; устройство отдельных алгоритмов требует отдельного разбора.
Кластеризация: найти похожие группы
Кластеризация объединяет объекты в группы по сходству выбранных признаков. Для магазина на вход можно подать сведения о частоте заказов, суммах и составе покупок каждого клиента за один и тот же период. На выходе получатся группы покупателей с похожим поведением по этим характеристикам.
В учебном примере одна группа может состоять из тех, кто часто делает небольшие заказы, другая — из тех, кто редко покупает много сразу. Такие описания даёт аналитик после просмотра результата. Сам алгоритм не устанавливает, почему люди покупают именно так, и не определяет автоматически их потребности.
Группировку можно использовать для исследования аудитории и подготовки гипотез о предложениях. Перед этим нужно убедиться, что группы достаточно устойчивы и различия полезны. Классификация решает другую задачу: учится выбирать уже заданные категории по примерам с известными метками.
Поиск ассоциативных правил: найти совместные сочетания
Поиск ассоциативных правил помогает обнаружить, какие элементы встречаются вместе. На вход подают, например, наборы товаров в чеках. Результат — связи вида «среди покупок с кофе часто встречается печенье», а не распределение покупателей по группам.
Для нашего магазина такая связь могла бы стать гипотезой для совместного предложения товаров. Но сначала нужно проверить, на скольких покупках она основана и насколько печенье популярно само по себе. Товар, который есть почти в каждом чеке, будет часто встречаться рядом со многими другими товарами.
Совместная покупка не доказывает, что один товар вызывает покупку другого. Сочетание может объясняться акцией, сезоном или особенностями ассортимента. Пользу нового предложения проверяют отдельно; найденное правило не гарантирует рост продаж.
Уменьшение размерности: представить данные компактнее
Уменьшение размерности, или снижение размерности, позволяет описать объект меньшим числом признаков. Представим, что у каждого покупателя есть много показателей покупок по категориям и месяцам. Некоторые меняются похожим образом. Метод может преобразовать их в несколько новых характеристик, которые сохраняют часть существенных различий между покупателями.
Объекты при этом остаются теми же, меняется их описание. Компактное представление используют для наглядного исследования данных или как вход для дальнейшего анализа. Например, покупателей можно показать точками на плоскости и посмотреть, какие из них расположились рядом.
При сжатии часть информации теряется, а новые характеристики не всегда легко объяснить. Красивые группы на картинке ещё не доказывают, что в исходных данных есть полезные сегменты. Если представление готовят для числового прогноза, проверяют качество самого прогноза: уменьшение числа признаков не обязано его улучшить.
Где применяется обучение без учителя
Одна история покупок позволяет поставить несколько задач. Для каждой понадобятся своё представление данных и своя проверка. Сравним возможные результаты на том же условном магазине.
| Вопрос | Данные | Результат | Как использовать |
|---|---|---|---|
| Какие покупатели похожи? | Характеристики покупок каждого клиента | Группы покупателей | Изучить различия и подготовить предложения для проверки |
| Какие товары встречаются вместе? | Состав каждого чека | Правила совместной встречаемости | Выбрать сочетания для проверки рекомендаций или комплектов |
| Как сравнить покупателей по множеству показателей? | Подробные характеристики каждого клиента | Более компактное представление | Исследовать данные и проверить пригодность для дальнейшего анализа |
Группировка документов. Другой учебный сценарий — архив обращений без готовых тематических меток. Тексты преобразуют в числовые признаки и объединяют похожие сообщения. Сотрудник читает примеры из групп и выясняет, какие вопросы повторяются. Группа может отражать общую тему, но также одинаковый шаблон письма или язык, поэтому смысл нужно проверять.
Поиск необычных наблюдений. Некоторые методы обучения без учителя помогают выделять записи, заметно отличающиеся от остальных. В истории заказов это может быть поводом проверить ошибку загрузки или необычный заказ. Отличие само по себе не доказывает нарушение и не заменяет разбор конкретного случая.
Какие данные нужны и как проверить результат
Отсутствие готовых ответов избавляет от необходимости размечать каждый пример, но не от подготовки данных. Начните с единицы наблюдения: одна строка описывает покупателя, чек или документ? Если смешать эти сущности, результат будет трудно понять.
- Выбирайте признаки под вопрос. Для сравнения покупательского поведения полезны сведения о покупках. Технический номер клиента обычно не описывает сходство людей: близкие номера могут означать лишь соседние записи в системе.
- Делайте наблюдения сопоставимыми. Число заказов за месяц и за год нельзя напрямую сравнивать как один показатель. Новый покупатель и клиент с долгой историей требуют учёта времени наблюдения.
- Разбирайтесь с пропусками и дублями. Отсутствующая сумма не равна нулевой покупке. Повторно загруженные чеки способны создать ложное впечатление о популярности сочетания товаров.
- Учитывайте масштаб признаков. Суммы в рублях и число заказов имеют разные диапазоны. В методах, чувствительных к расстояниям, крупные числовые значения могут подавить другие характеристики. Способ приведения к сопоставимому масштабу выбирают с учётом метода и смысла данных.
- Проверяйте разнообразие данных. История одной акции может плохо описывать обычные покупки. Важны разные периоды и ситуации, с которыми предстоит работать.
Универсального минимального объёма данных нет. Он зависит от задачи, числа признаков, разнообразия объектов и того, насколько редкие сочетания нужно находить. Большая таблица с ошибками и повторами не становится качественной только из-за числа строк.
Без эталонных ответов нельзя просто посчитать долю верных предсказаний. Проверка складывается из нескольких вопросов:
- Есть ли понятный смысл? Просмотрите реальные примеры внутри найденных групп и проверьте, чем они различаются. Название группы должно соответствовать наблюдениям, а не ожиданиям аналитика.
- Сохраняется ли результат? Проверьте другие периоды, подвыборки и разумные варианты настроек. Если вывод полностью меняется от небольшого изменения данных, использовать его стоит осторожно.
- Подходит ли проверка к задаче? Для кластеров важны сходство внутри групп и различия между ними, для правил — повторяемость сочетаний с учётом общей популярности товаров. Для компактного представления оценивают потерю информации и качество последующего анализа.
- Помогает ли результат действовать? Сравните использование найденных закономерностей с простым исходным подходом. Например, проверьте, полезнее ли предложение для выделенной группы, чем обычная подборка популярных товаров.
Если подготовленные без учителя признаки затем используются в модели прогноза, их преобразование настраивают только на обучающей части данных. Отложенные примеры сохраняют для независимой проверки всей цепочки. Подробнее этот принцип разобран в статье об обучении и проверке модели.
Чем обучение без учителя отличается от обучения с учителем
Главное различие — задан ли целевой ответ в обучающих примерах. При обучении с учителем алгоритм учится связывать признаки с такими ответами. При обучении без учителя он исследует структуру выбранных данных без этих подсказок.
Допустим, магазин хочет предсказывать, вернётся ли покупатель в следующем месяце. Если в истории уже известно, кто вернулся, это задача классификации с ответами «да» и «нет». Если нужен прогноз суммы следующей покупки, речь идёт о регрессии. А вопрос «какие группы покупателей есть в нашей базе?» можно исследовать кластеризацией без готовых меток групп.
Подходы могут дополнять друг друга. Сначала можно изучить структуру обращений, затем согласовать категории и разметить примеры для классификатора. Но найденные кластеры не становятся правильными ответами автоматически: их ещё нужно проверить и сопоставить с задачей.
Обучение с подкреплением устроено иначе: система выбирает действия и учится с учётом получаемого вознаграждения. А самостоятельное изучение человеком нового предмета — обычное значение слов «учиться без учителя», не название рассматриваемого здесь метода машинного обучения.
Преимущества и ограничения
Обучение без учителя полезно, когда данных уже много, а готовых целевых ответов нет или вопрос состоит в исследовании их структуры. Оно помогает увидеть повторяющиеся особенности, подготовить гипотезы и упростить дальнейший анализ без предварительной разметки каждого объекта.
При этом найденная закономерность ещё не является готовым решением. Результат зависит от выбранных признаков, периода наблюдения и настроек метода. Группы могут отражать ошибки данных, частые сочетания — временную акцию, а компактное представление — потерять информацию, важную для следующей задачи.
Есть и затраты: данные нужно собрать и очистить, расчёты — выполнить, результаты — объяснить и проверить. Отсутствие меток не гарантирует, что проект будет проще или дешевле обучения с учителем. Автоматически определить, какой результат полезен бизнесу, по одной красивой схеме или внутреннему показателю качества нельзя.
Для первого практического шага выберите один конкретный вопрос и заранее решите, что будете делать с ответом. Затем подготовьте подходящие данные, получите результат и проверьте его смысл, устойчивость и пользу. Такой порядок помогает понять, где найденная структура действительно нужна в работе.